베이스 다이·CoWoS의 다음 — 스택 자체의 물리적 한계선으로
앞서 HBM4 베이스 다이 글에서는 베이스 다이의 파운드리 전환을 다뤘습니다. CoWoS 글에서는 HBM이 놓이는 인터포저의 확장을 봤습니다. 이번 글은 HBM 스택 자체의 물리적 한계선으로 시선을 옮깁니다. 16단·20단으로 층수를 올릴 때 왜 마이크로범프를 없애는 하이브리드 본딩이 거론됐는지 살펴봅니다. 그리고 업계 예측보다 이 전환이 늦어지는 이유를 '775µm 높이 규격'이라는 잣대로 풀어 봅니다.
16단은 어디까지 왔나 — 양산 12단, 인증 16단
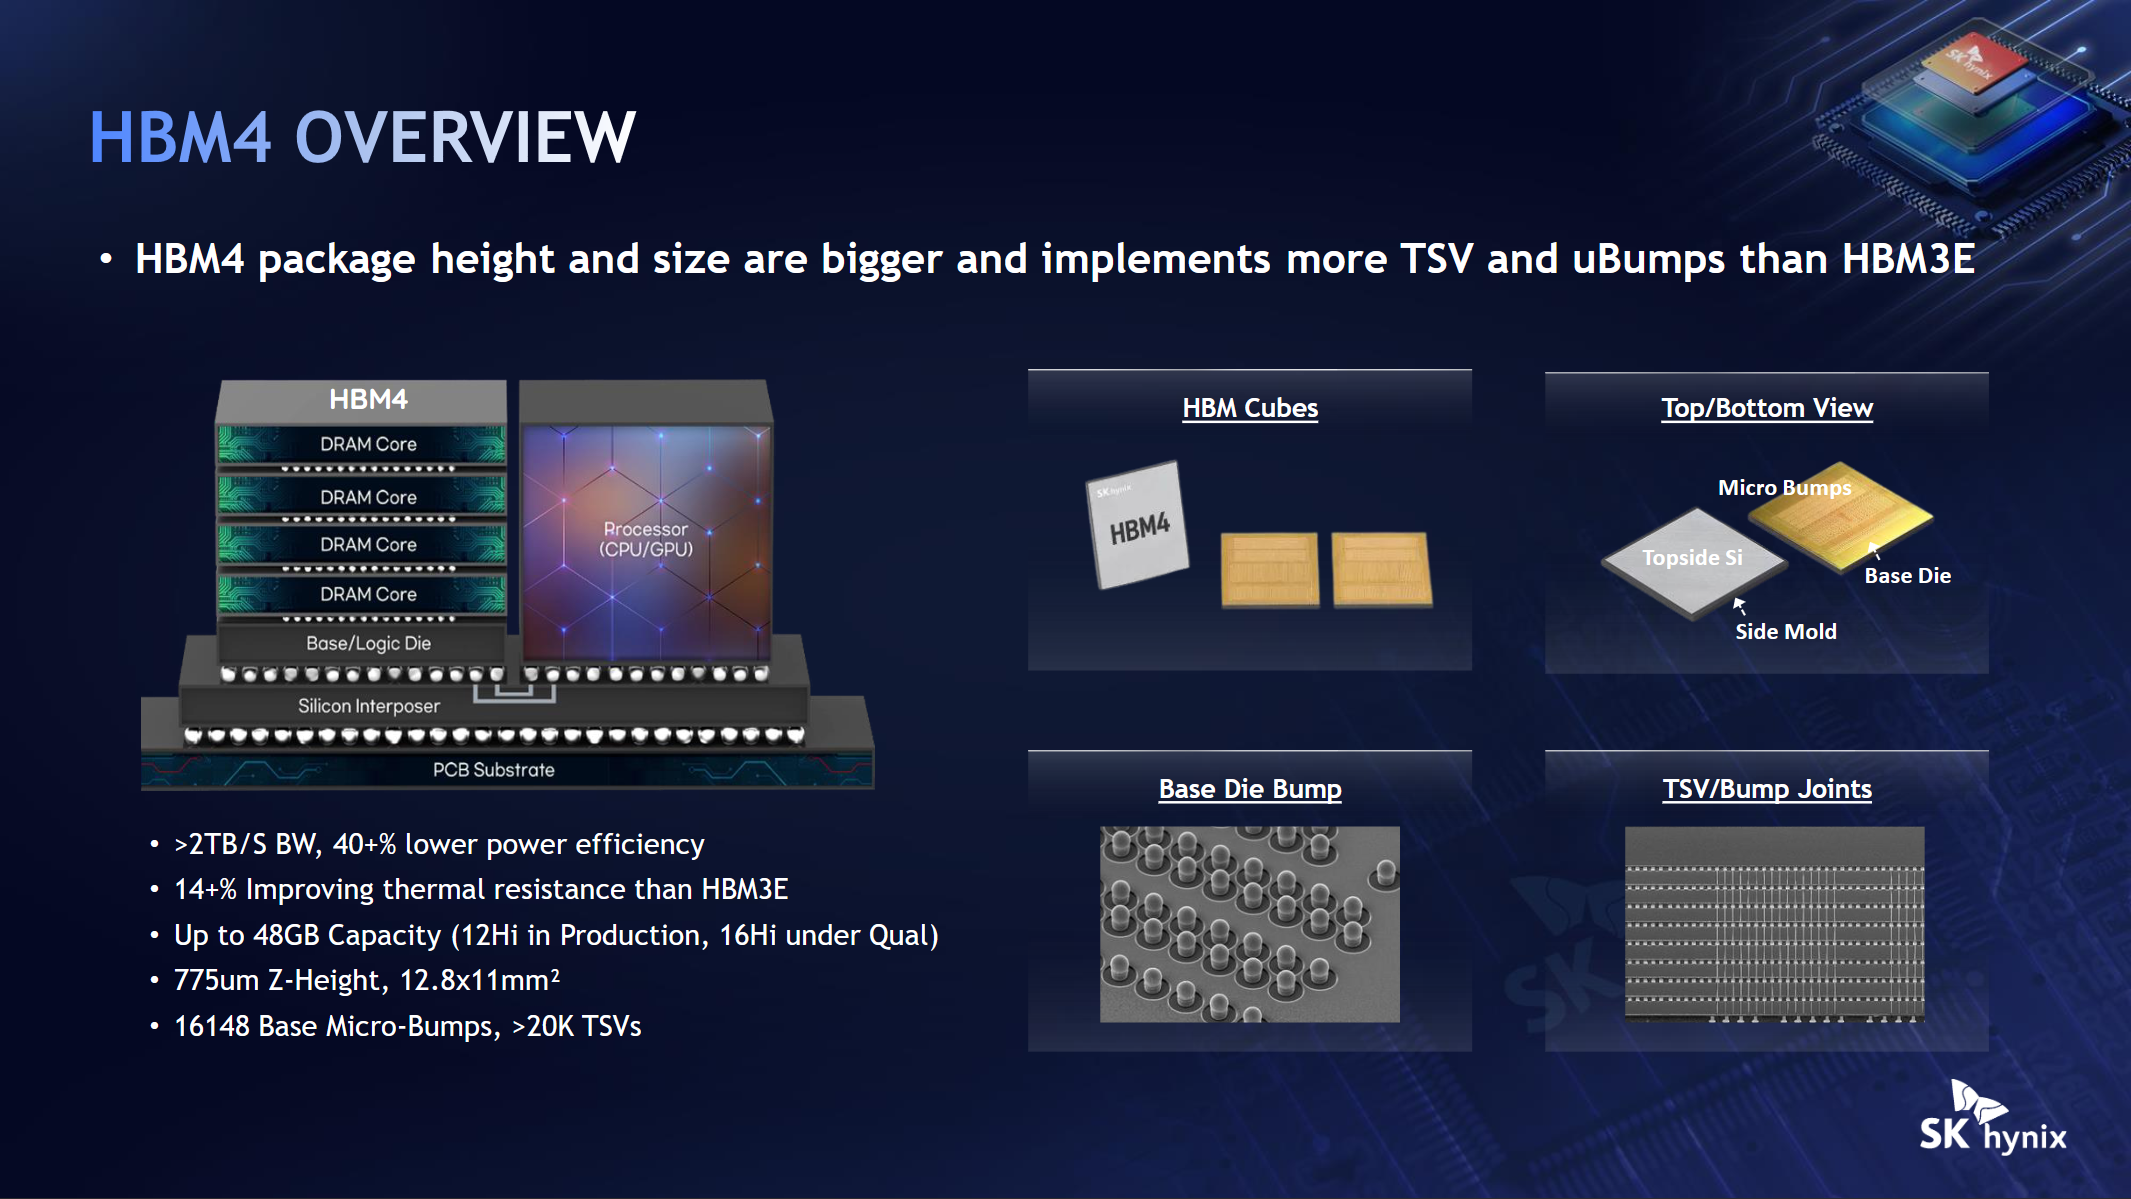
2026년 8월 23일 핫칩스에서 SK하이닉스 이재식 부사장(SK하이닉스 아메리카 패키지 엔지니어링)이 현황을 밝혔습니다. HBM4 12단은 양산 중이고, 16단(48GB)은 고객 인증 단계라는 내용입니다. 근거는 핫칩스 발표 슬라이드이며 톰스 하드웨어와 헤럴드경제가 보도했습니다. 16단 HBM4는 1월 CES 2026에서 실물이 먼저 공개됐습니다. 당시 트렌드포스는 "고객 일정에 맞춰 개발 중"이라고 전했습니다. JEDEC HBM4 표준(JESD270-4)이 정의한 최대 적층 단수도 16단입니다. 같은 행사에서 젠슨 황 엔비디아 CEO가 메모리 3사 모두 HBM4 퀄 테스트를 통과했다고 언급한 것으로 보도됐습니다. 헤럴드경제 보도이며 발언 원문은 확인하지 못했습니다.
775µm — 왜 높이가 병목인가
HBM 스택의 높이는 JEDEC 표준으로 묶여 있습니다. HBM3E까지 720µm였던 상한은 HBM4 표준 확정 과정에서 775µm로 완화됐다고 보도됐습니다. JEDEC이 2025년 4월 표준을 공개했고 트렌드포스가 전한 내용입니다. SK하이닉스 발표 슬라이드도 HBM4 제품 높이를 775µm(12.8×11mm²)로 적었습니다. JEDEC 규격 도면의 치수 정의·공차는 이 글에서 직접 확인하지 못했습니다. 이 숫자가 왜 하필 775인지는 이재식 부사장의 설명이 명쾌합니다. GPU 패키지에 콜드 플레이트를 붙일 때는 로직 다이와 메모리 스택을 함께 갈아 맨 실리콘을 드러냅니다. 로직 웨이퍼 두께가 775µm라서, 메모리 큐브가 그보다 높으면 옆의 프로세서 위로 튀어나온다는 것입니다. 톰스 하드웨어가 인용한 설명입니다. GPU와 HBM을 함께 냉각하는 패키지에서는 각 부품의 상면 높이와 열계면재 두께를 맞추는 설계가 필요합니다. 열계면재는 냉각판과 칩 사이의 열 전달을 돕는 소재입니다. 상면 높이 차이를 열계면재와 냉각 구조 설계에 적절히 반영하지 못하면 접촉과 방열 성능이 떨어질 수 있습니다. 이는 구조 일반론이며 허용 공차 수치는 공개 자료가 없습니다.
그래서 제한된 높이에 16단을 넣으려면 코어 다이 두께와 다이 사이 접합 간격을 함께 줄여야 합니다. 16단 HBM4는 코어 다이를 12단보다 얇게 깎고 다이 사이 간격을 절반으로 줄였다고 톰스 하드웨어는 발표를 인용해 전했습니다. 다이 두께 수치는 보도마다 표현이 달라 이 글에서는 적지 않습니다. 대가가 있습니다. 다이가 얇아질수록 스택에서 열전도가 나쁜 산화막 비중이 커집니다. 핀 속도는 초기 HBM 1Gbps에서 HBM4 8Gbps로 올라 같은 면적에 더 많은 전력이 몰립니다. SK하이닉스 자체 계산으로 열 부담은 세대를 거치며 2.2배, 스택 수는 두 세대마다 두 배입니다(발표 기준). 인하대 워크숍(9/3)에서 최리노 인하대 교수는 자신의 계산을 근거로 열 문제를 설명했습니다. HBM은 GPU(800W)보다 적은 50W를 소비합니다. 그러나 D램을 여러 장 쌓은 구조라 열이 빠져나가지 못해, AI 반도체 전체의 온도 상한을 사실상 HBM이 정한다는 설명입니다(디일렉 보도).
관련 도표 보기
두 가지 붙이는 법 — MR-MUF와 하이브리드 본딩
지금 HBM은 마이크로범프로 다이를 잇습니다. SK하이닉스의 MR-MUF(매스 리플로우 몰디드 언더필)는 다이를 픽앤플레이스로 쌓은 뒤 한 번의 리플로우로 접합합니다. 그다음 다이 사이 빈 공간에 액체 보호재를 주입해 굳힙니다. SK하이닉스 뉴스룸 설명이며, 열 방출 30% 개선은 회사 발표 기준이고 HBM3 8단·12단에 적용됐습니다. 16단에서는 절반으로 줄어든 틈을 빈틈없이 채우면서 얇아진 다이의 휨을 잡는 것이 최대 제조 과제라고 이재식 부사장은 말했습니다(톰스 인용). 삼성전자는 필름형 언더필을 끼우고 열압착하는 TC-NCF 방식을 써 왔습니다(전자신문). 범프는 HBM 안에서 다이를 쌓을 때만 쓰이는 게 아닙니다. 메모리 업체가 쌓아 보낸 HBM을 인터포저에 붙이는 CoWoS 쪽 접합도 마이크로범프입니다.
TSMC는 이 접합용으로 협력사에 5µm급 범프·언더필 과제를 내며 하이브리드 본딩 대신 마이크로범프를 당분간 유지한다는 보도가 있습니다. 전자신문 9/2 보도이며, 범프 높이 기준으로 HBM3E 15~25µm, HBM4 약 10µm이고 5µm급 양산은 2028년 하반기로 추정·보도됐습니다. 범프 높이(다이와 다이, 또는 HBM과 인터포저 사이의 간격)와 범프 피치(접점과 접점 사이 거리)는 다른 치수입니다. 그래서 아래 비교표에서는 높이와 피치를 별도 행으로 구분합니다.
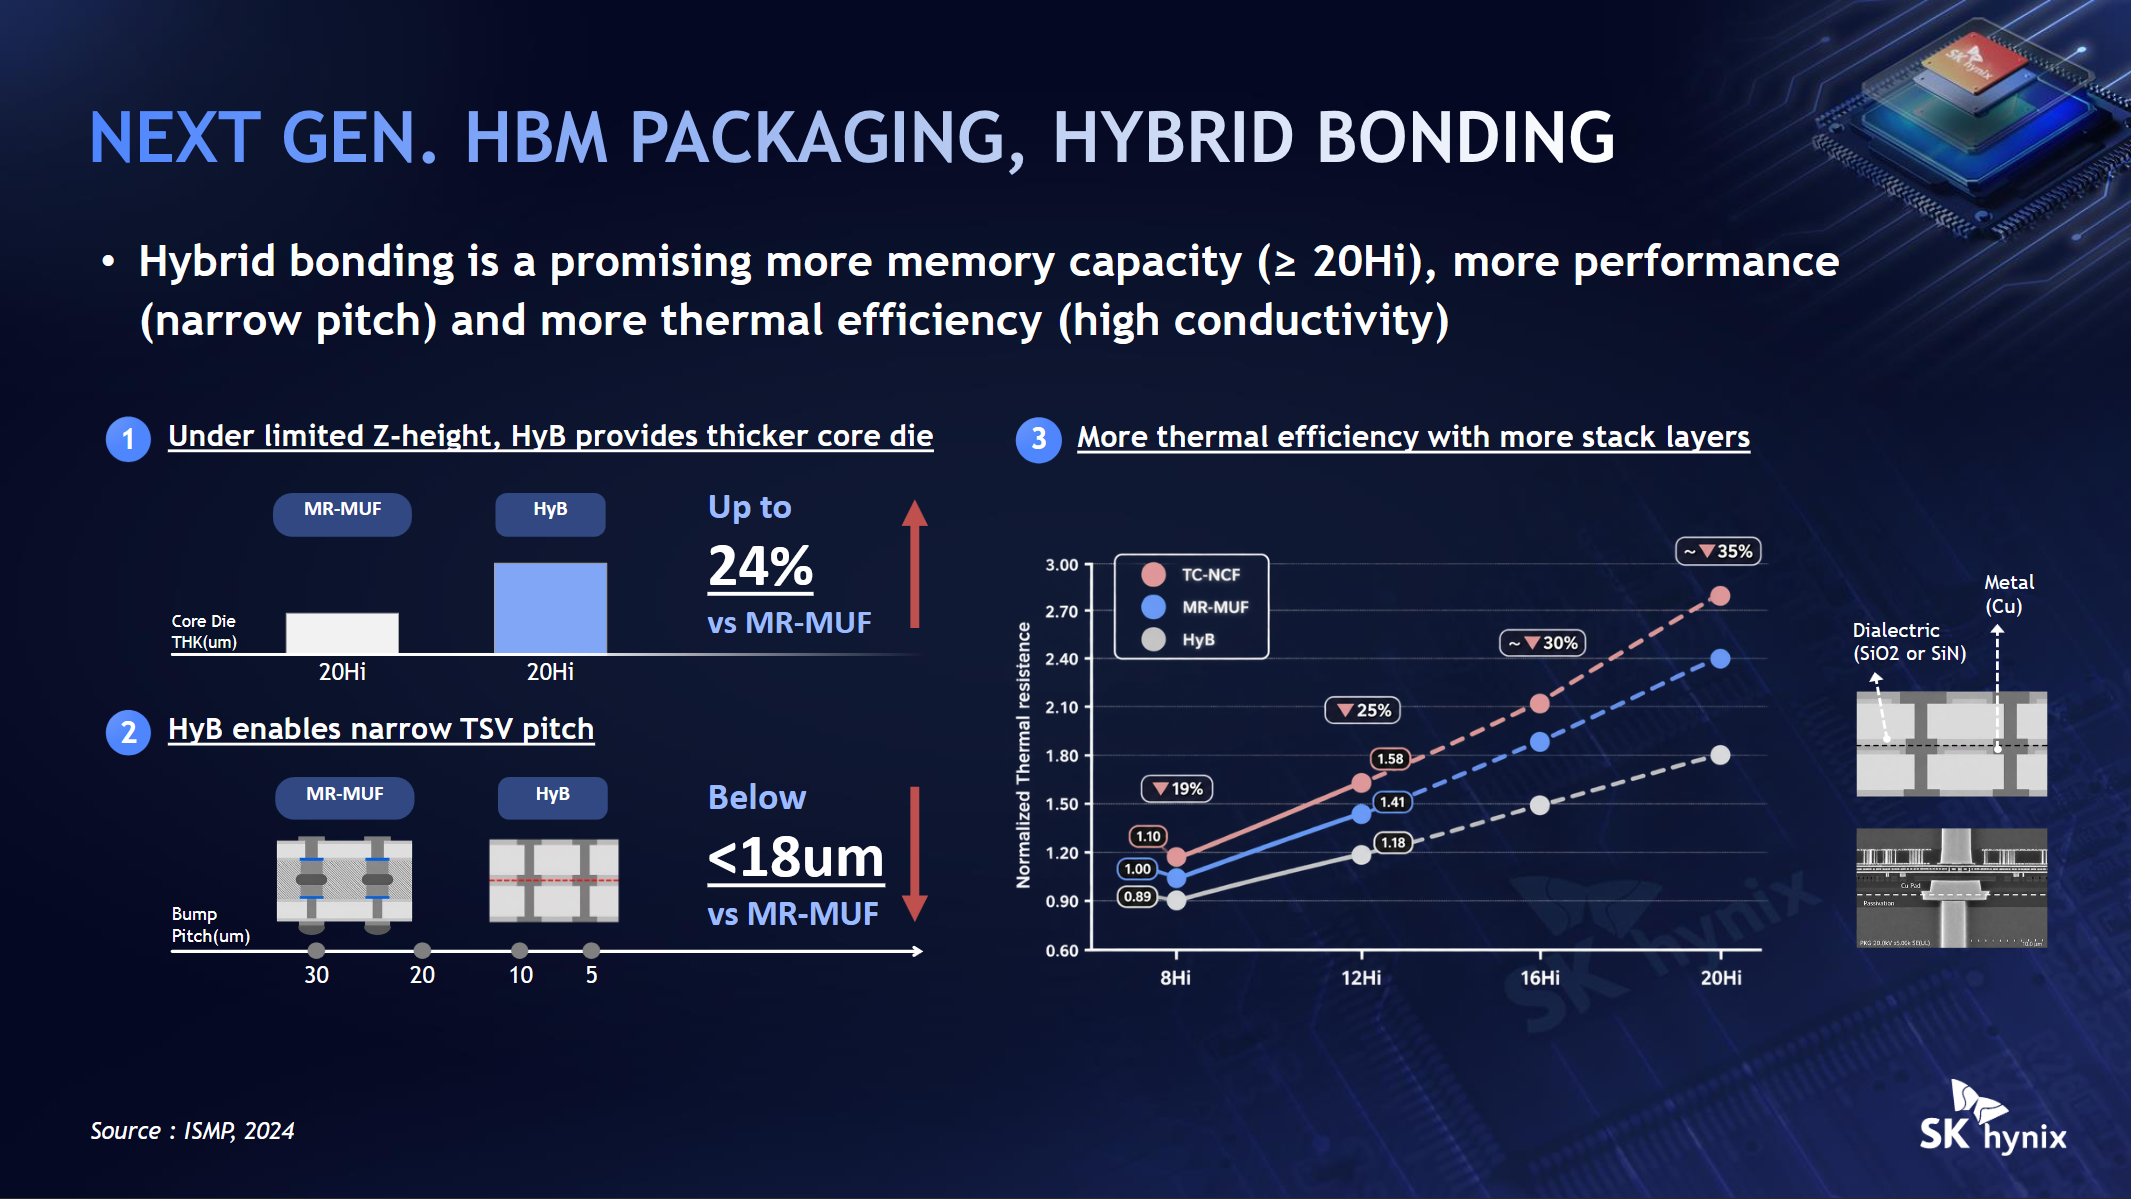
하이브리드 본딩은 범프를 아예 없앱니다. 두 다이의 표면을 평탄하게 연마한 뒤 구리 패드와 주변 유전체를 직접 맞대어 접합합니다. 상온에서 유전체가 먼저 붙고, 200~300°C 큐어 단계에서 구리가 열팽창해 전기적으로 연결됩니다(톰스 9/2 종합·핫칩스 발표). 범프가 없으니 다이를 더 두껍게 유지하면서 더 촘촘하게 연결할 수 있습니다. SK하이닉스는 20단 비교에서 하이브리드 본딩을 적용하면 MR-MUF 대비 코어 다이를 최대 24% 두껍게 유지할 수 있다고 제시했습니다. 같은 슬라이드의 열저항 약 35% 감소 수치는 TC-NCF 대비입니다(그래프상 MR-MUF 대비로는 약 25%). 범프 피치는 MR-MUF 30µm에서 18µm 미만으로 좁힐 수 있다고 적었습니다(회사 발표 슬라이드, 출처 ISMP 2024). 같은 워크숍에서 최창환 한양대 교수는 자신의 시뮬레이션 사례를 들었습니다.
D램 8장 적층 시 마이크로범프 방식 95도, 하이브리드 본딩 70도라는 수치입니다. 디일렉 보도이며 발표자 사례라서 일반적 보장은 아닙니다. 로직 쪽에서는 이미 양산 기술입니다. TSMC SoIC가 9→6µm 피치로 양산 중이고 2029년 4.5µm 로드맵을 두고 있습니다. 인텔 Foveros Direct는 9µm로 클리어워터 포레스트에 적용돼 2026년 상반기 출하됩니다. AMD 3D V-캐시는 첫 세대부터 이 방식이었습니다(톰스 9/2). NAND에서도 키옥시아가 CMOS 웨이퍼와 셀 어레이 웨이퍼를 구리 직접 접합으로 잇는 CBA 구조를 BiCS FLASH 8세대 제품에 적용했다고 밝히고 있습니다(키옥시아 공식). 이 글의 쟁점은 HBM의 DRAM 다층 적층에 언제 본격 적용되느냐입니다.
그런데 왜 늦어지나 — '아직 안 써도 되게 된' 표준
핫칩스에서 나온 가장 큰 뉴스는 SK하이닉스가 하이브리드 본딩이 HBM4E에는 준비되지 않을 것이라고 말했다는 보도입니다. 이재식 부사장은 목표 세대를 지목하지 않았고, 어느 제품에 먼저 넣을지는 회사가 아직 결정하지 않았다고 했습니다. HBM4E를 배제하면 HBM5가 최초 가능 슬롯이라는 것은 톰스 하드웨어의 해석입니다. 이유는 세 겹입니다.
우선 표준이 여유를 줬습니다. JEDEC이 상한을 775µm로 올리면서 16단을 마이크로범프로도 조립할 수 있게 됐습니다(톰스 9/2). 업계는 20단을 겨냥해 825~900µm 추가 완화를 논의 중입니다. 톰스 하드웨어 8/24 보도와 이코노믹리뷰 3/30·뉴시스 3/31 보도 내용이며, HBM4E부터 적용될 가능성이 거론됩니다. ZDNet(7/6)은 HBM5에서 1,000µm까지 거론된다는 보도까지 전했습니다. 톰스는 지금까지 JEDEC이 상한을 올릴 때마다 MR-MUF가 한 세대 더 쓰였다고 짚었습니다(과거 경과에 대한 매체 관찰).
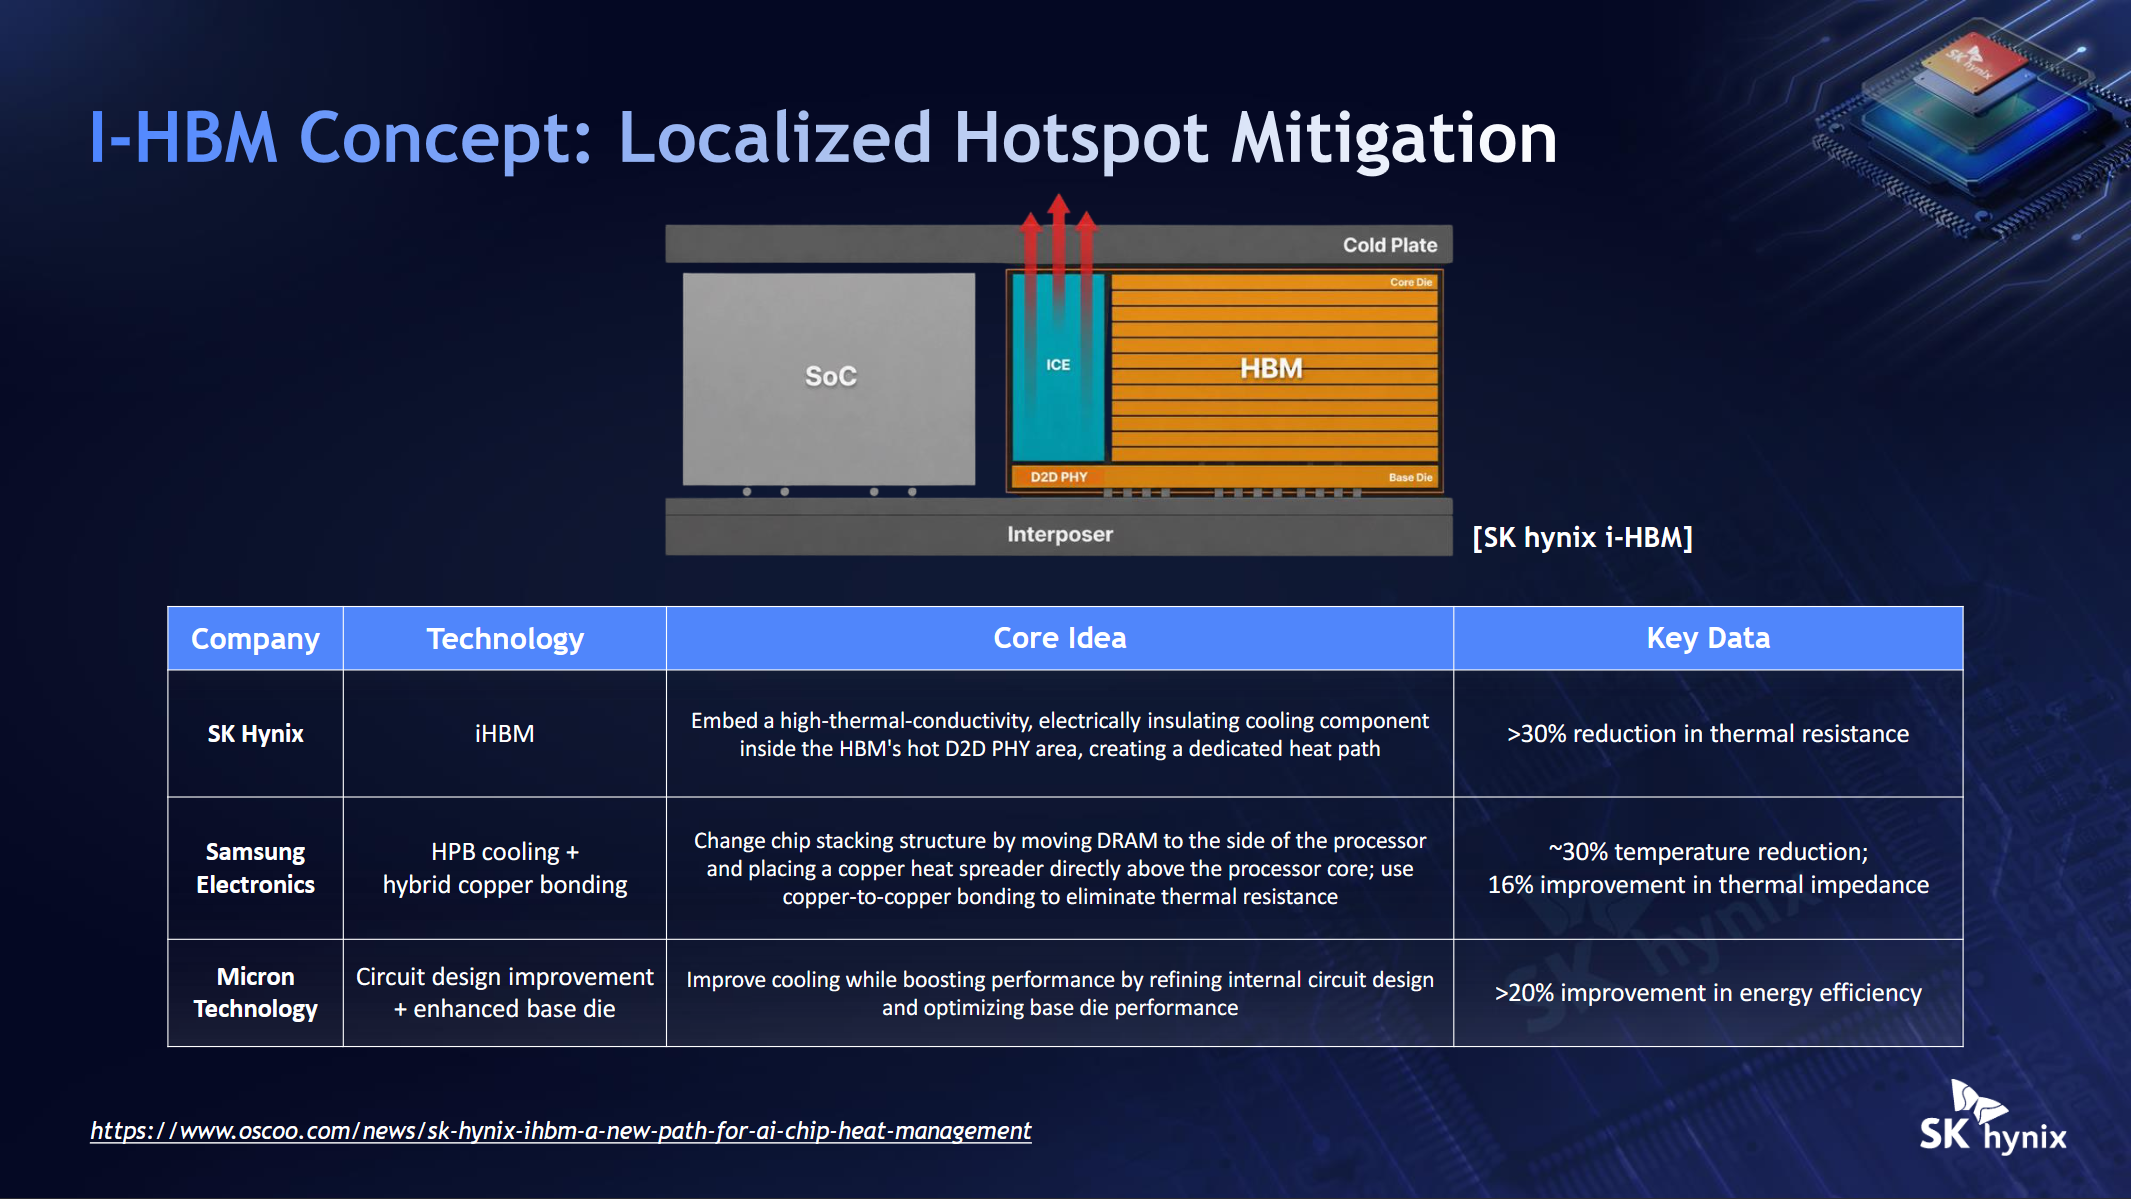
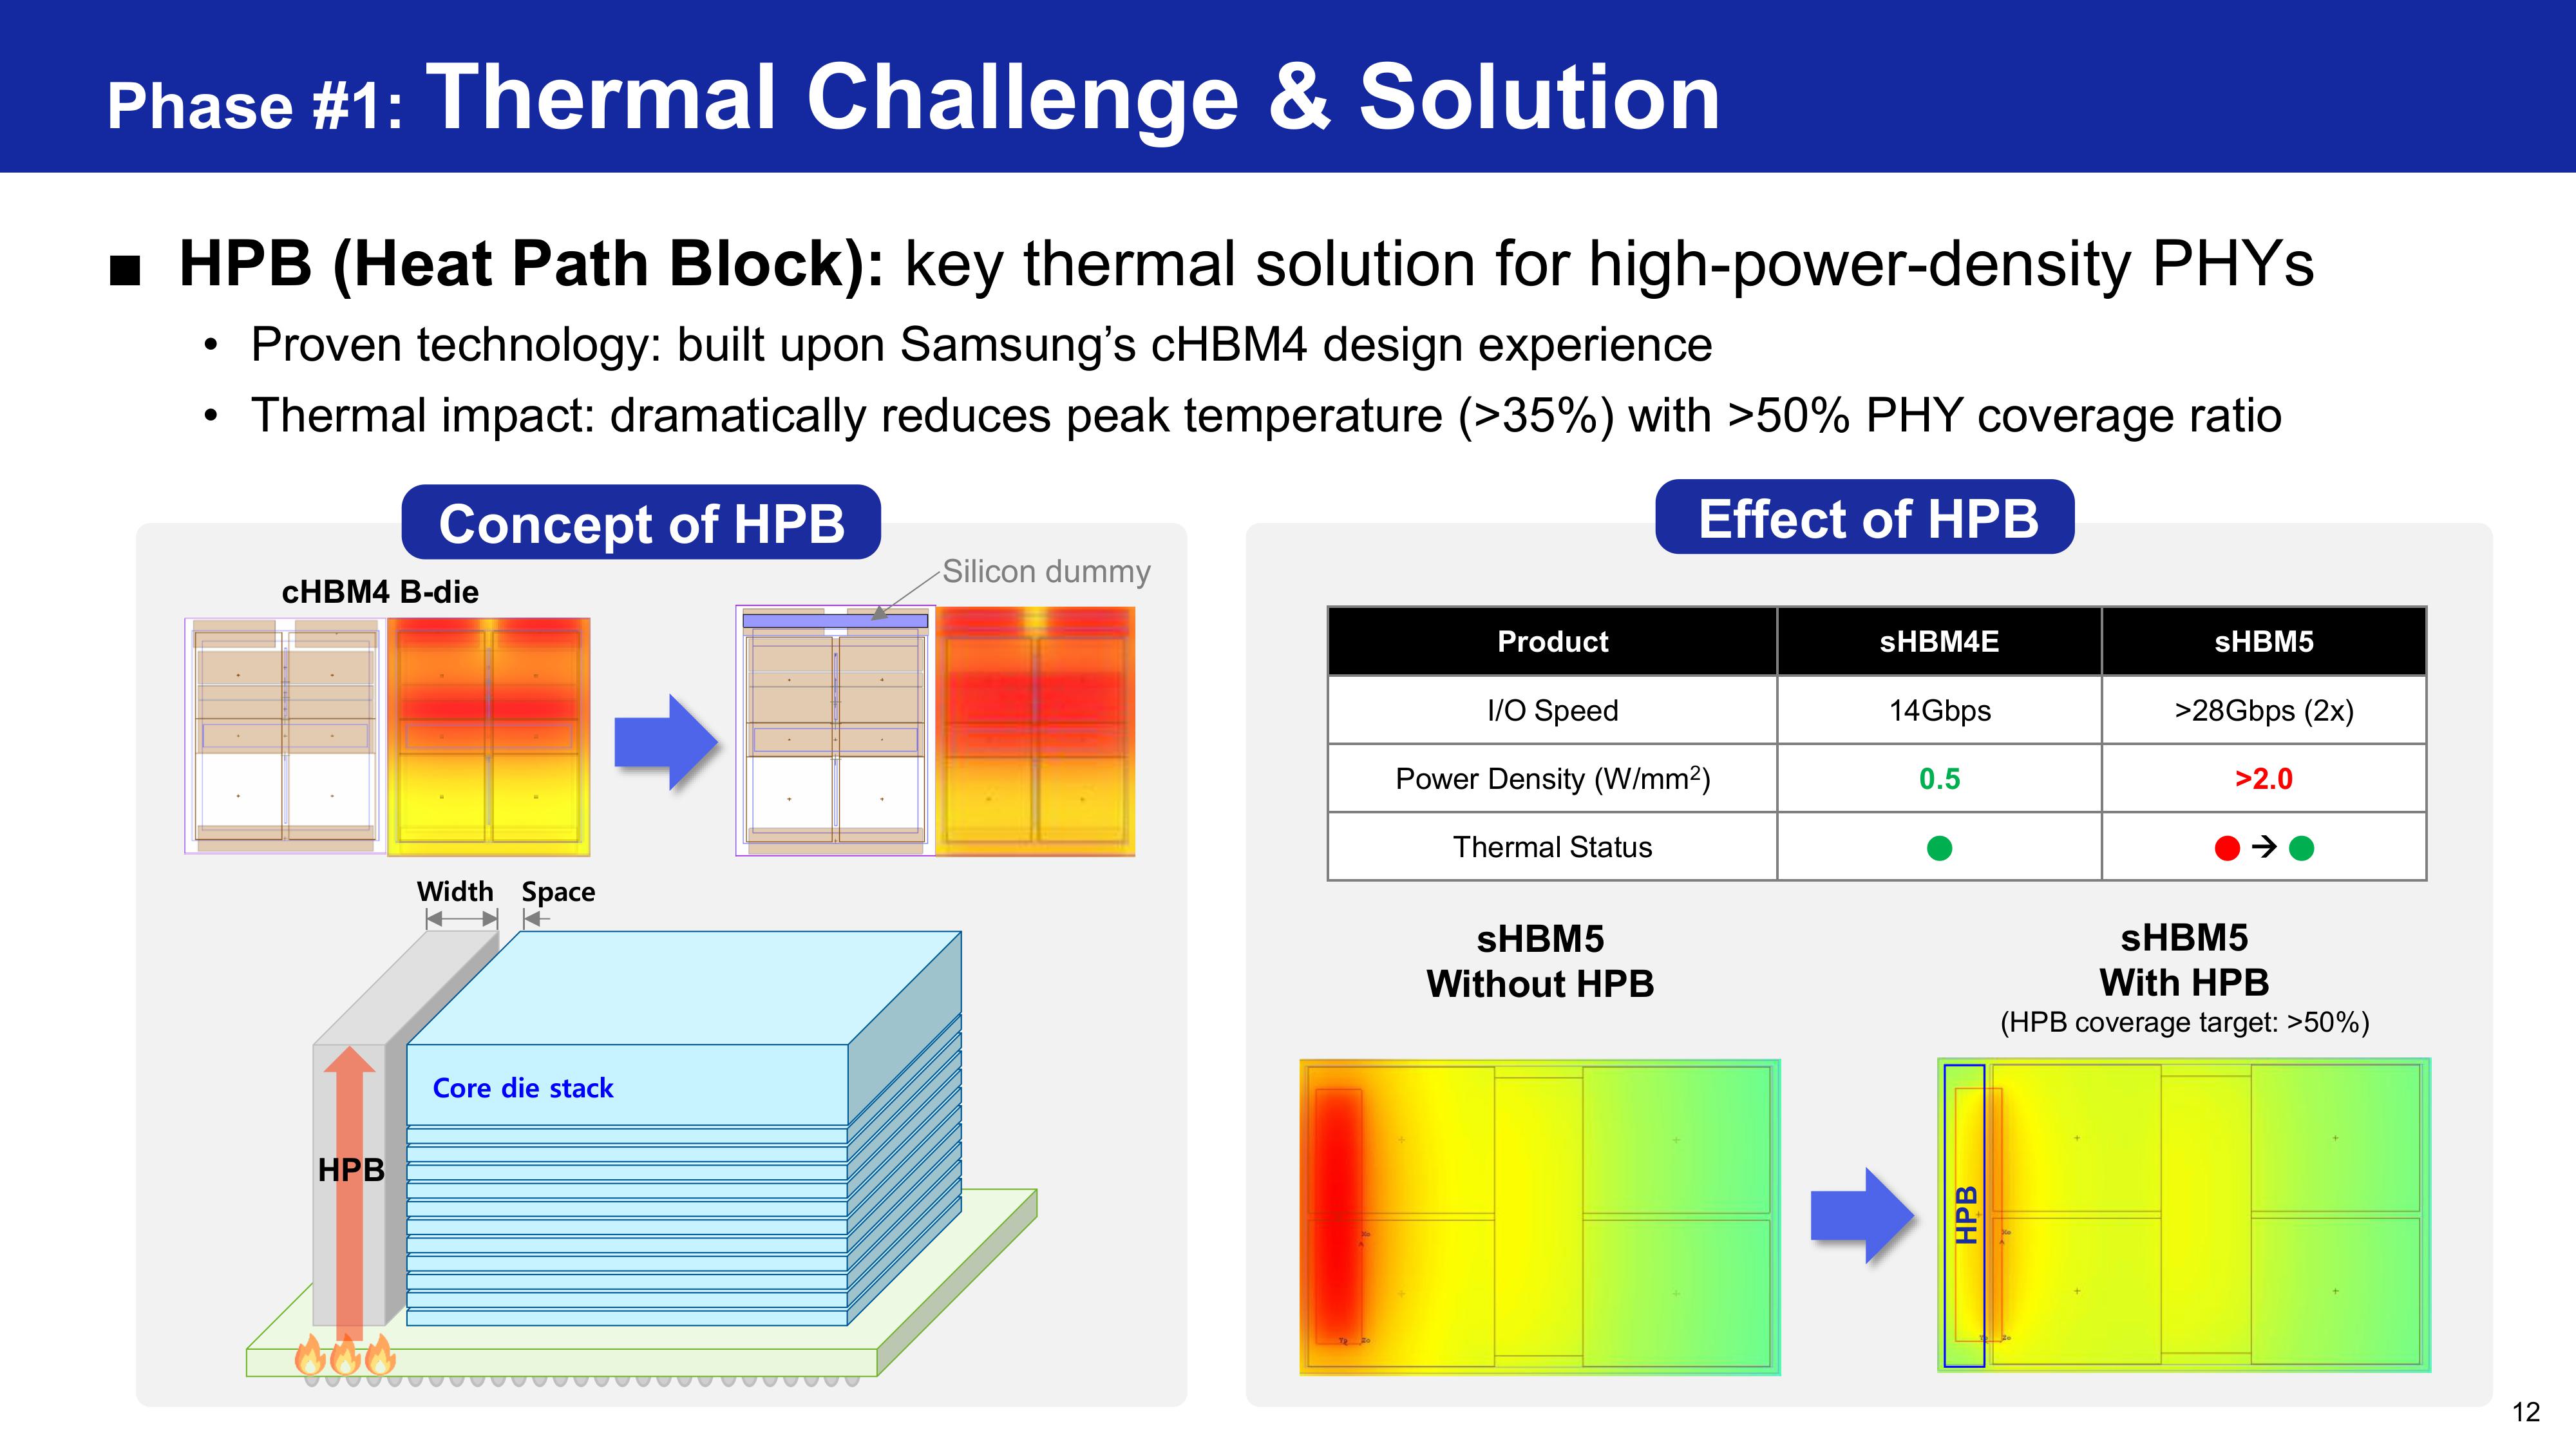
다음으로 열 문제는 다른 부품으로 풉니다. 양사는 HBM 내부의 국부 발열을 완화하기 위한 별도 열전달 구조도 제시했습니다. SK하이닉스 iHBM은 베이스 다이의 다이-투-다이 PHY 발열 영역에서 상부 냉각 구조(콜드 플레이트)로 열을 전달하는 열전도성·전기절연 블록입니다. 열저항 30% 이상 감소를 주장합니다. 삼성 히트 패스 블록(HPB)은 cHBM4 설계 경험을 기반으로 PHY 면적 50% 이상을 덮어 피크 온도를 35% 이상 낮춘다는 구조입니다. 슬라이드에서는 sHBM5 적용 사례를 보였습니다(각사 발표 슬라이드). 적용 제품과 양산 시점은 각사의 발표를 구분해 확인할 부분입니다. 톰스는 두 설계 모두 HBM5를 겨냥하며 2028년 전 양산은 없다고 전했습니다(보도). 이재식 부사장은 고객 설계와 함께 최적화해야 해서 이미 설계 중인 세대에는 넣을 수 없다고 말했습니다(톰스 인용). ZDNet은 업계 관계자를 인용해 이런 방열 부품이 "기술적으로 어렵지 않은 안정적 선택"이라고 전했습니다.
마지막은 비용·수율·장비입니다. 하이브리드 본딩은 접합 유전체 표면의 거칠기를 극도로 낮추고 구리 패드 높이와 오염 입자를 정밀하게 관리해야 합니다. 계측 기술자료는 유전체 표면의 RMS 거칠기로 0.1~0.2nm 수준, 구리 패드 리세스는 수 nm 수준을 제시합니다(Bruker 응용노트). 서브미크론 입자 하나가 여러 패드를 띄우는 공정이라 세정·평탄화가 수율을 좌우합니다. HBM처럼 개별 다이를 골라 쌓는 다이-투-웨이퍼 방식은 장비 처리량이 한계입니다. AMAT+Besi Kinex가 시간당 약 1,600개, Besi Chameo가 약 2,000개 수준입니다(톰스 9/2). 이재식 부사장의 말대로 "원리는 단순하지만 실제로는 정말 어렵고, 16단·20단을 하이브리드 본딩으로 만드는 건 한 층 쌓는 것과는 전혀 다른" 일입니다(톰스 인용).
시점 전망은 출처마다 조금씩 다릅니다. SK하이닉스 발표는 'HBM4E에는 준비되지 않는다'이고, HBM5 최초 가능은 톰스 해석입니다. 카운터포인트는 HBM5와 함께 2029~2030년 본격 적용을 봅니다(톰스 인용). 최창환 한양대 교수는 워크숍에서 "HBM4에는 들어가지 않고 2030년대 초반쯤"(디일렉)이라고 내다봤습니다. 삼성전자는 2025년 5월 HBM4에 하이브리드 본딩을 쓰겠다고 공개적으로 밝혔다가 표준 완화 이후 시점이 흐려졌습니다(톰스 8/24). 삼성이 HBM4E부터, SK가 HBM5부터라는 업계 관측도 보도됐습니다. 비바100 4/9 보도이며 관측 수위입니다. 다만 늦어진 것이지 사라진 것은 아닙니다. HBM5E에서 I/O가 4,096개로 두 배가 되면 기존 열압착 본딩의 간격으로는 어려워 다시 필요해진다는 것이 ZDNet이 전한 업계 시각입니다.
SK하이닉스가 3월 첫 양산용 하이브리드 본더(약 200억 원 규모)를 발주했다는 보도도 있습니다. 톰스가 업계 소식통을 인용한 내용입니다. SK하이닉스의 8월 28일 공식 착공 발표는 인디애나 투자액을 40억 달러 초과, 클린룸 개장을 2028년 10월, 양산을 2029년 하반기 목표로 구분합니다. 클린룸 개장 목표를 양산 가동일로 읽으면 안 됩니다. 이 발표만으로 하이브리드 본딩 도입 시점을 확정할 수도 없습니다.
관련 근거: [23] SK하이닉스 — 인디애나 착공, 투자 40억 달러 초과·2028년 10월 클린룸 개장·2029년 하반기 양산 목표 (2026-08-28)
삼성의 다른 답 — 스택을 더 쌓는 대신 밑에 로직을
삼성전자는 zHBM을 HBM과 연산 장치(xPU)를 수직으로 직접 통합하는 차세대 구조로 설명합니다. 공식 기술 블로그는 웨이퍼 온 웨이퍼 방식과 하이브리드 구리 본딩을 제시합니다. 데이터 입출력 경로를 분산하고 연결 거리를 줄여 대역폭과 에너지 효율을 높이려는 설계입니다.
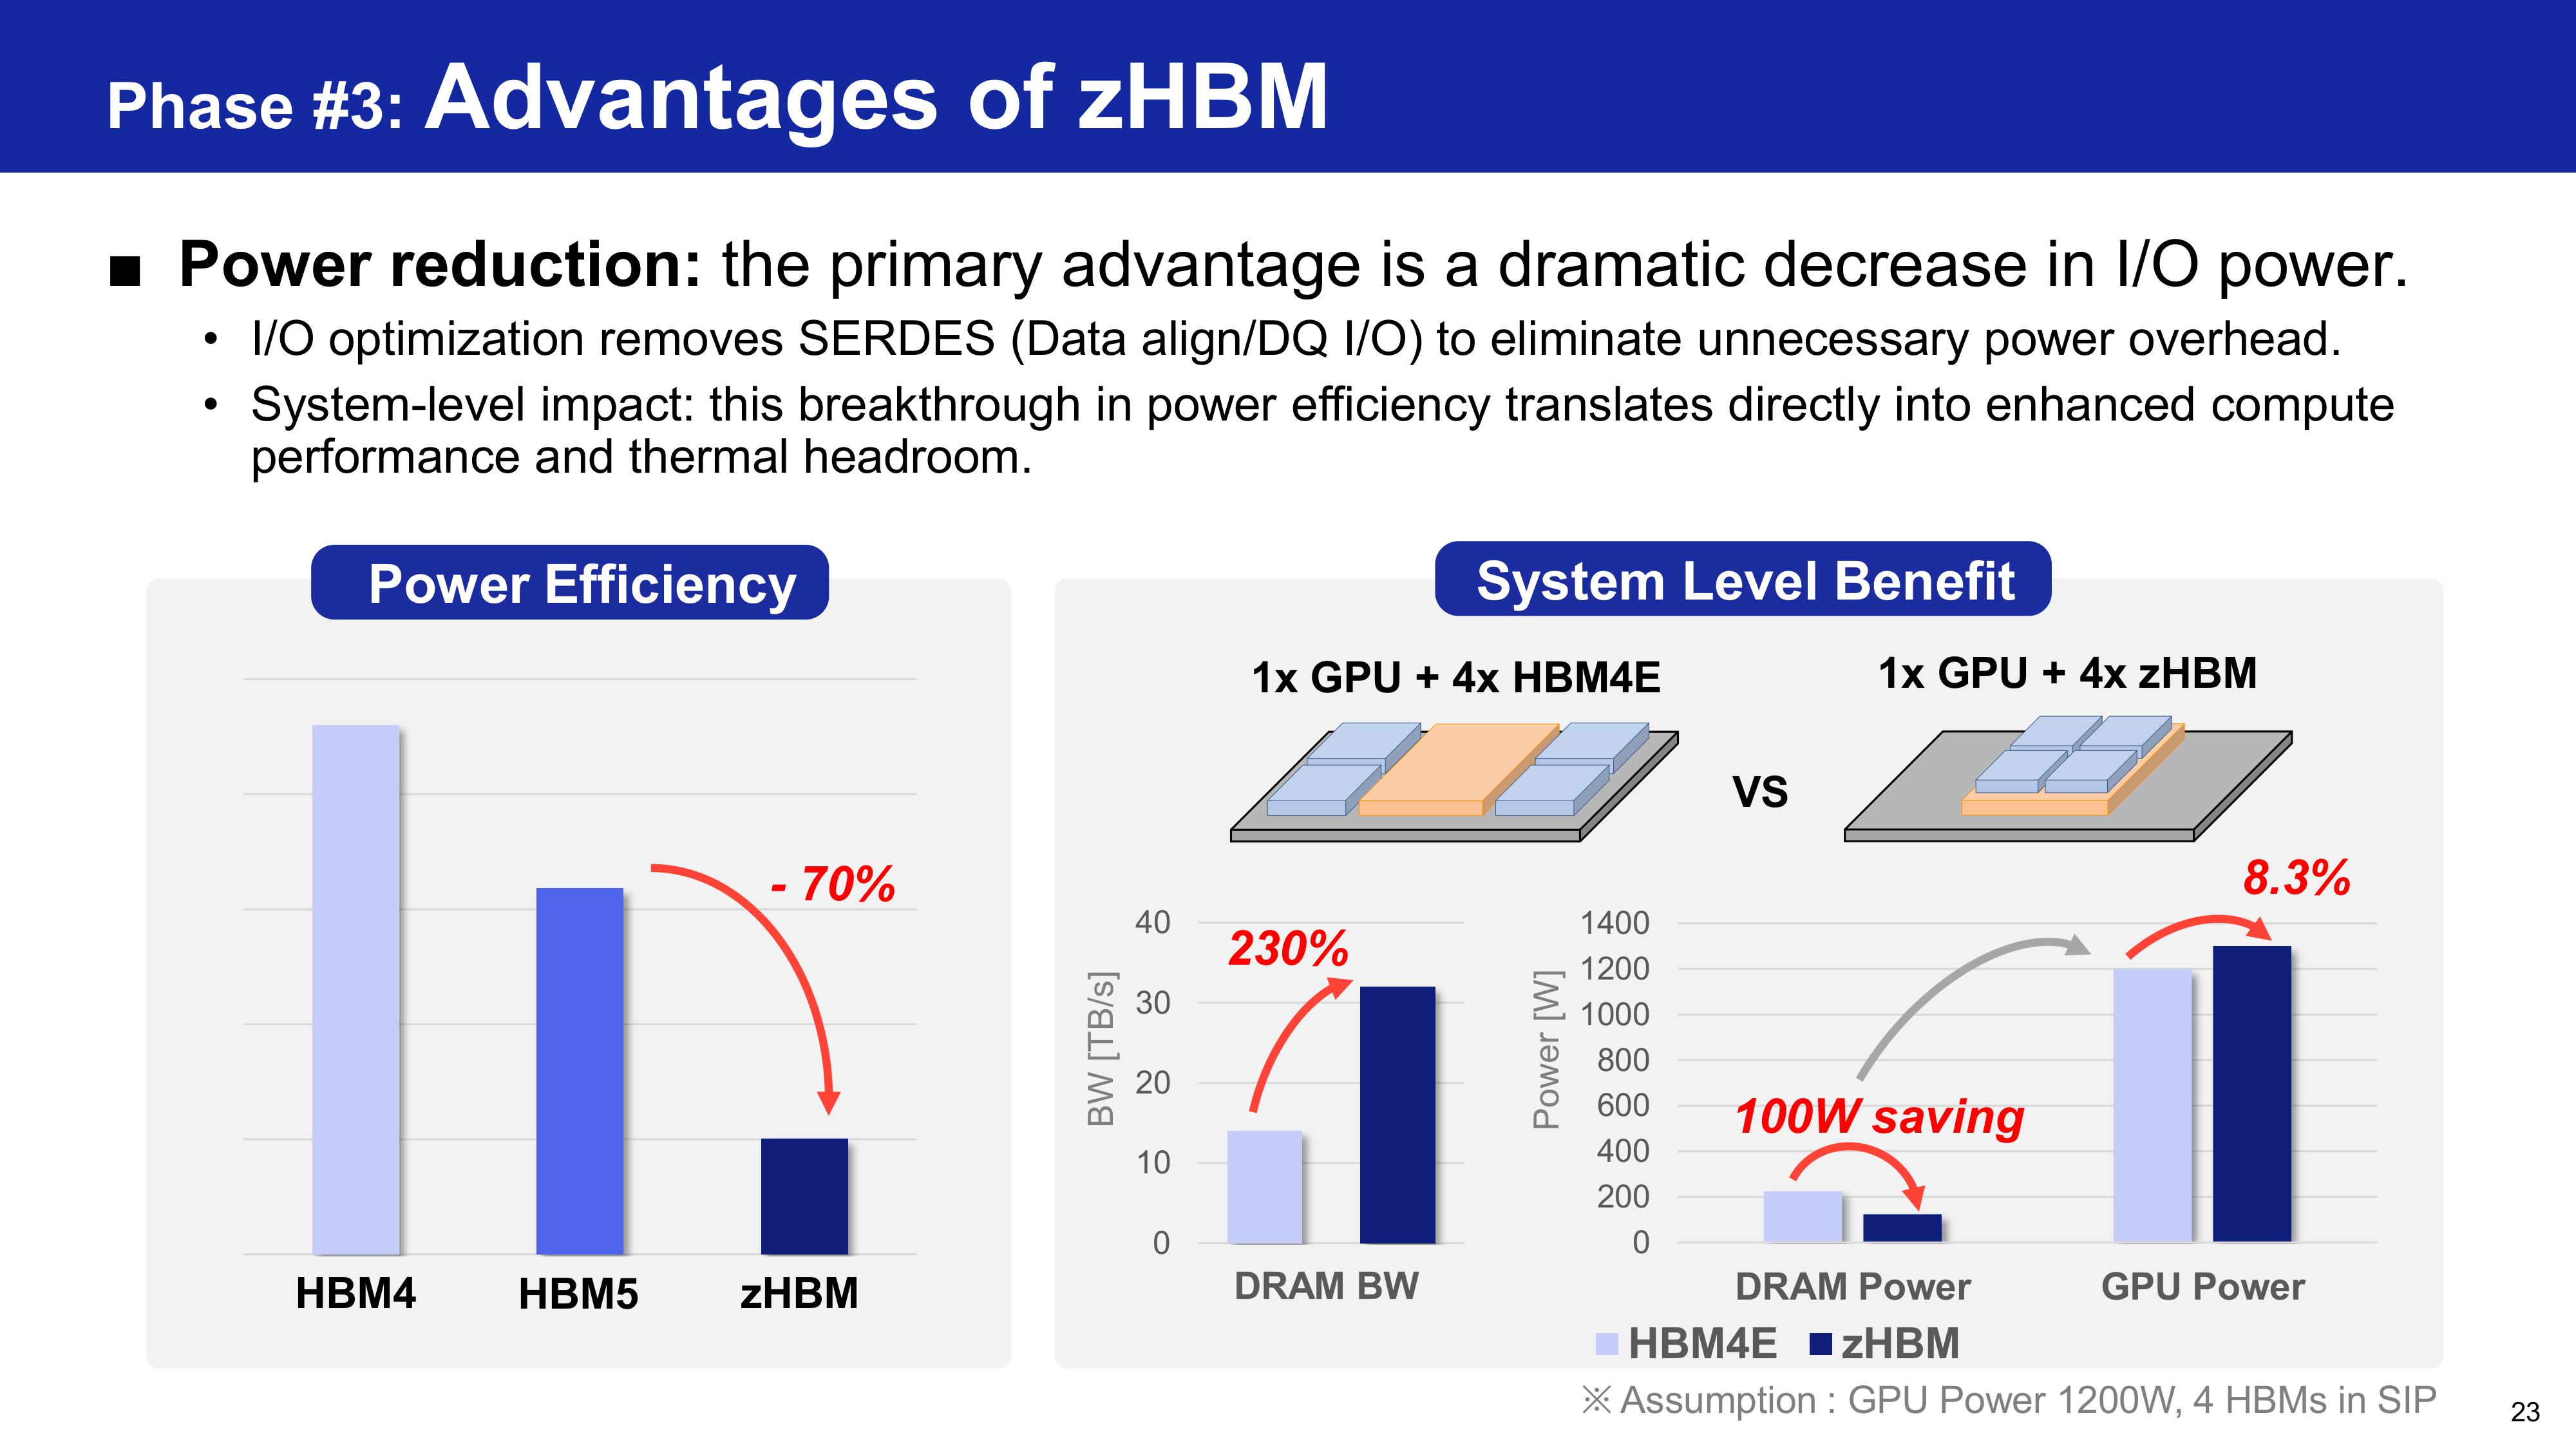
핫칩스 발표 슬라이드 23쪽은 I/O 전력 감소를 가장 큰 이점으로 꼽습니다. 데이터를 직렬과 병렬로 바꾸는 회로(SERDES)를 없애 불필요한 전력 소모를 줄인다는 설명입니다. 같은 쪽의 'Power Efficiency' 그래프에는 HBM5 막대에서 zHBM 막대로 향하는 '−70%' 표시가 있습니다. 다만 세로축의 단위와 계산식은 적혀 있지 않습니다. 이 표시만으로는 I/O 소비전력이 70% 줄어드는지, 전력 효율이 70% 높아지는지 가릴 수 없습니다. 트렌드포스는 다른 매체를 인용해 zHBM이 HBM4E 대비 전력 효율을 70% 높인다고 전했습니다. 그러나 슬라이드에서 이 화살표가 출발하는 막대는 HBM5입니다.
같은 쪽의 시스템 비교는 기준이 다릅니다. GPU 1개에 HBM4E 4개를 붙인 구성과 GPU 1개에 zHBM 4개를 올린 구성을 견줍니다. DRAM 대역폭 막대는 약 14TB/s와 32TB/s로, 약 2.3배입니다. 슬라이드의 '230%'는 2.3배라는 뜻이며 230% 증가가 아닙니다.
전력 막대는 메모리에서 약 100W를 줄이고 그만큼을 GPU에 더 배분하는 예시입니다. 가정한 GPU 전력은 1,200W이고 zHBM 구성에서는 1,300W로 표시됩니다. 시스템 전체 전력이 100W 줄어든다는 뜻은 아닙니다. 가정에 기초한 설계 예시이므로 실제 제품의 측정값으로 읽기는 어렵습니다.
삼성은 열 관리와 xPU·zHBM의 공동 설계가 필요하다고 설명합니다. xPU의 열이 메모리 스택을 통과해야 하기 때문입니다. 이 구상에서 하이브리드 본딩은 HBM 다이를 더 많이 쌓는 문제를 넘어, 메모리와 연산 장치의 연결 방식을 바꾸는 역할을 합니다. HBM4 베이스 다이와 CoWoS 해설을 함께 읽으면 로직의 위치와 패키지 구조가 어떻게 달라지는지 비교할 수 있습니다.
관련 근거: [7] 삼성전자 핫칩스 2026 발표 슬라이드 — zHBM 장점 23쪽 (Tom’s Hardware CDN 보관본)[11] TrendForce — Hot Chips 2026: Samsung zHBM·SK hynix EMIB, 2026-08-24[24] 삼성전자 반도체 기술 블로그 — zHBM 구조·분산형 I/O·공동 설계 (2026-09-29 열람)
한국 접점 — 이 기술은 이미 법정에도 섰다
HBM 적층 공정은 한국이 세계를 이끄는 몇 안 되는 반도체 후공정 영역입니다. 하이브리드 본딩은 그 다음 세대의 핵심이라 국내 장비사·소재사 움직임이 잦습니다. SK하이닉스가 한화세미텍과 2027년 상용화를 목표로 본더를 개발 중이라는 보도가 있고(톰스 9/2 인용), 삼성은 GTC(3월)에서 하이브리드 본딩이 TC 본딩 대비 열저항 20% 이상 낮다고 밝혔습니다. 모두 보도 기준이며, 개별 기업의 수주·양산 여부는 공시로 확인할 사항입니다. 이 기술의 국내 위상은 법정에서도 드러났습니다. 산업기술보호법 해설 글에서 다룬 사건은 '하이브리드 본딩' 기술이 범행 당시 첨단기술 고시에 없어 그 부분이 무죄로 남은 사례였습니다.
편집자 판단 — 높이 규격과 양산 경제성을 함께 봐야
제 판단으로는 하이브리드 본딩의 도입 시점을 이해하려면 높이 규격과 양산 경제성을 함께 봐야 합니다. 반도체 제조에서 신기술 도입을 결정하는 것은 '신기술이 우수한가'만이 아닙니다. '기존 양산 공정이 물리적 한계에 닿았는가'도 함께 작용합니다. JEDEC이 높이 상한을 720에서 775µm로 넓히고 차기 규격에서 900µm 완화를 논의하면서, 검증된 마이크로범프 방식(MR-MUF 등)의 적용 여지가 넓어질 수 있습니다. HBM은 파운드리의 로직 칩렛과 달리 16~20개의 양품 다이를 결함 없이 차례로 쌓아야 합니다. 그래서 파티클 제어와 원자 수준의 표면 거칠기 관리(CMP)가 요구되는 하이브리드 본딩의 수율·원가 부담이 더 큽니다. 다만 실제 전환은 접점 밀도, 열 관리, 수율, 장비 처리량, 고객 요구가 함께 결정합니다. 높이 규격의 변경만으로 도입이 정확히 한 세대 늦어진다고 단정하기는 어렵습니다. 관전 포인트는 두 개입니다. JEDEC이 900µm(또는 그 이상)를 실제로 확정하느냐, 그리고 HBM5·HBM5E에서 I/O 밀도가 마이크로범프의 간격 한계를 넘느냐입니다. 각사가 최초 적용 제품을 발표하는 시점에 맞춰 이 글의 시간표를 다시 적겠습니다.